Hadoop 海量數(shù)據(jù)存儲(chǔ)與計(jì)算的基石,數(shù)據(jù)處理與存儲(chǔ)的強(qiáng)大支撐
在當(dāng)今信息爆炸的時(shí)代,企業(yè)每天都會(huì)產(chǎn)生PB甚至EB級(jí)別的數(shù)據(jù),如何高效、可靠且經(jīng)濟(jì)地存儲(chǔ)和處理這些海量數(shù)據(jù),已成為一項(xiàng)核心挑戰(zhàn)。Apache Hadoop應(yīng)運(yùn)而生,作為一個(gè)開源的分布式系統(tǒng)基礎(chǔ)架構(gòu),它從根本上解決了海量數(shù)據(jù)的存儲(chǔ)和計(jì)算問題,并為此提供了一套完整的、可擴(kuò)展的數(shù)據(jù)處理和存儲(chǔ)支持服務(wù)。
一、 解決海量數(shù)據(jù)存儲(chǔ)問題:HDFS
Hadoop的核心組件之一——Hadoop分布式文件系統(tǒng)(HDFS),是其存儲(chǔ)能力的基石。HDFS的設(shè)計(jì)哲學(xué)是將超大規(guī)模文件(如TB、PB級(jí))以數(shù)據(jù)塊的形式,分布存儲(chǔ)在由成百上千臺(tái)廉價(jià)商用服務(wù)器組成的集群中。這種設(shè)計(jì)帶來了多重優(yōu)勢(shì):
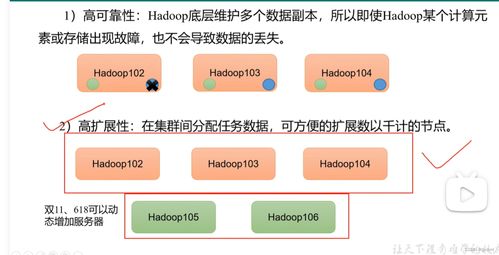
- 高容錯(cuò)性:數(shù)據(jù)被自動(dòng)復(fù)制成多個(gè)副本(默認(rèn)3份),并存儲(chǔ)在不同節(jié)點(diǎn)上。即使單個(gè)或少數(shù)節(jié)點(diǎn)發(fā)生故障,數(shù)據(jù)也不會(huì)丟失,系統(tǒng)依然可以正常運(yùn)行。
- 高吞吐量:數(shù)據(jù)訪問采用“一次寫入、多次讀取”的模式,并支持大規(guī)模數(shù)據(jù)的流式讀取,非常適合大數(shù)據(jù)分析場(chǎng)景,而非低延遲的交互式訪問。
- 可擴(kuò)展性:存儲(chǔ)容量和計(jì)算能力可以通過簡(jiǎn)單地增加集群節(jié)點(diǎn)來線性擴(kuò)展,滿足數(shù)據(jù)量不斷增長(zhǎng)的需求。
- 經(jīng)濟(jì)性:Hadoop集群可以構(gòu)建在廉價(jià)的商用硬件上,相比傳統(tǒng)的大型機(jī)和高端存儲(chǔ),成本大幅降低。
二、 解決海量數(shù)據(jù)計(jì)算問題:MapReduce與YARN
存儲(chǔ)問題解決后,如何在這些海量數(shù)據(jù)上執(zhí)行復(fù)雜的計(jì)算任務(wù)?Hadoop提供了其經(jīng)典的編程模型和計(jì)算框架。
- MapReduce編程模型:這是一種“分而治之”的思想。它將復(fù)雜的計(jì)算任務(wù)分解為兩個(gè)主要階段:Map(映射)和Reduce(歸約)。在Map階段,任務(wù)被并行化處理,每個(gè)節(jié)點(diǎn)處理其本地存儲(chǔ)的數(shù)據(jù)塊;在Reduce階段,Map階段的中間結(jié)果被匯總,產(chǎn)生最終結(jié)果。這種模型將計(jì)算任務(wù)移動(dòng)到數(shù)據(jù)所在節(jié)點(diǎn),極大地減少了數(shù)據(jù)在網(wǎng)絡(luò)中的傳輸,非常適合批處理作業(yè)。
- YARN資源調(diào)度器:在Hadoop 2.0之后引入的YARN(Yet Another Resource Negotiator),將資源管理與作業(yè)調(diào)度/監(jiān)控功能分離,成為一個(gè)通用的集群資源管理平臺(tái)。它允許多種數(shù)據(jù)處理框架(如MapReduce、Spark、Flink等)共享同一個(gè)HDFS集群上的數(shù)據(jù)和計(jì)算資源,極大地提升了集群的利用率和多任務(wù)并發(fā)處理能力,使Hadoop從一個(gè)單一的計(jì)算系統(tǒng)演變?yōu)橐粋€(gè)企業(yè)級(jí)的數(shù)據(jù)操作系統(tǒng)。
三、 完整的數(shù)據(jù)處理與存儲(chǔ)支持服務(wù)生態(tài)
Hadoop不僅僅是一個(gè)存儲(chǔ)和計(jì)算框架,它已經(jīng)發(fā)展成為一個(gè)功能豐富的生態(tài)系統(tǒng),圍繞HDFS和YARN,提供了全方位的數(shù)據(jù)服務(wù)支持:
? 數(shù)據(jù)采集:Sqoop用于在Hadoop與傳統(tǒng)關(guān)系型數(shù)據(jù)庫(kù)(如MySQL、Oracle)之間高效傳輸批量數(shù)據(jù);Flume用于高效收集、聚合和移動(dòng)海量日志數(shù)據(jù)流。
? 數(shù)據(jù)管理與倉(cāng)庫(kù):Hive提供基于SQL的數(shù)據(jù)查詢與分析功能,將復(fù)雜的MapReduce程序簡(jiǎn)化為類SQL語(yǔ)句,降低了使用門檻;HBase是一個(gè)構(gòu)建在HDFS之上的分布式、可擴(kuò)展的NoSQL數(shù)據(jù)庫(kù),支持對(duì)海量數(shù)據(jù)的實(shí)時(shí)隨機(jī)讀寫。
? 數(shù)據(jù)處理與分析:除了MapReduce,Spark憑借其內(nèi)存計(jì)算和DAG執(zhí)行引擎,提供了更快的迭代計(jì)算和流處理能力;Pig提供了一個(gè)高級(jí)腳本語(yǔ)言平臺(tái),用于簡(jiǎn)化MapReduce編程流程。
? 協(xié)調(diào)與管理:ZooKeeper為分布式應(yīng)用提供高可用的協(xié)調(diào)服務(wù),如配置維護(hù)、命名服務(wù)、分布式同步等,是許多Hadoop組件(如HBase)穩(wěn)定運(yùn)行的基礎(chǔ)。
? 工作流調(diào)度:Oozie用于管理和調(diào)度復(fù)雜的Hadoop作業(yè)工作流,可以將多個(gè)MapReduce、Pig、Hive等任務(wù)串聯(lián)起來順序執(zhí)行。
Hadoop通過其核心的分布式存儲(chǔ)(HDFS)和資源調(diào)度(YARN)架構(gòu),結(jié)合豐富強(qiáng)大的生態(tài)系統(tǒng)工具,構(gòu)建了一個(gè)完整、健壯且經(jīng)濟(jì)高效的海量數(shù)據(jù)處理與存儲(chǔ)解決方案。它使得企業(yè)能夠存儲(chǔ)過去難以想象規(guī)模的數(shù)據(jù),并能夠從中挖掘出寶貴的業(yè)務(wù)洞察,真正將“數(shù)據(jù)資產(chǎn)”的價(jià)值最大化,成為驅(qū)動(dòng)現(xiàn)代數(shù)據(jù)驅(qū)動(dòng)型決策和智能化應(yīng)用的堅(jiān)實(shí)后盾。
如若轉(zhuǎn)載,請(qǐng)注明出處:http://m.hualianhou.com/product/4.html
更新時(shí)間:2026-10-25 17:16:12